

Huawei เปิด Atlas 960E SuperPoD: AI infrastructure ปี 2026 แข่งกันที่ optical fabric และ memory pool
สารบัญบทความ (Table of Contents)
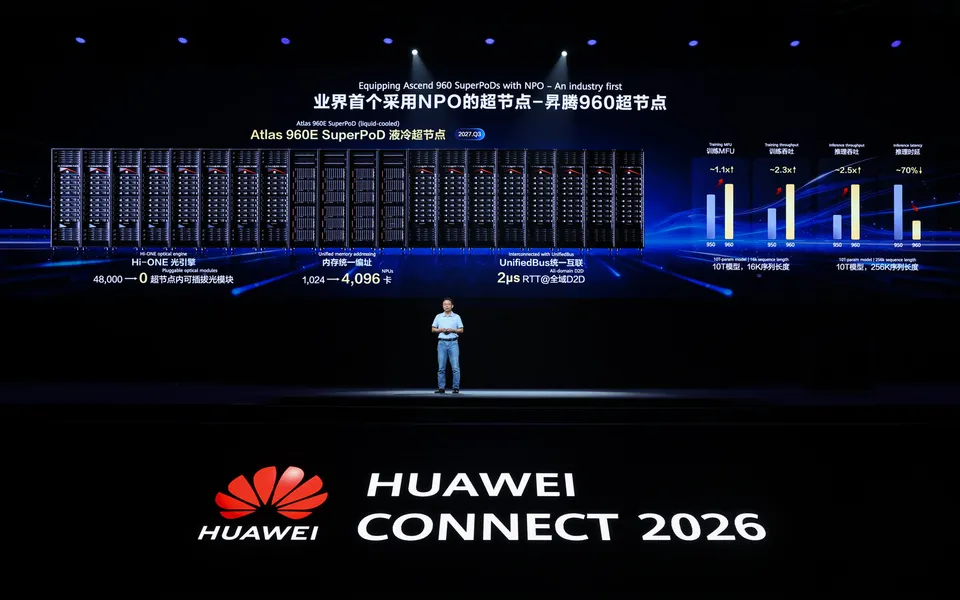
ข่าว Hardware / Infrastructure สำหรับรอบวันที่ 21 กันยายน 2026 คือ Huawei เปิดตัว Atlas 960E SuperPoD ในงาน HUAWEI CONNECT 2026 ที่เซี่ยงไฮ้เมื่อวันที่ 17 กันยายน 2026 โดยบริษัทระบุว่าเป็น SuperPoD รุ่นแรกของอุตสาหกรรมที่ใช้ near-packaged optics (NPO) เพื่อเร่งงาน training และ inference สำหรับโมเดลระดับ 10 ล้านล้านพารามิเตอร์
ตัวเลขที่ Huawei ชูทำให้ข่าวนี้เป็นมากกว่า hardware launch ทั่วไป: ระบบหนึ่ง SuperPoD รองรับ 4,096 NPUs, ให้สมรรถนะ 8 EFLOPS ที่ FP8 และ 16 EFLOPS ที่ FP4, ใช้ Hi-ONE optical engines 5,500 หน่วย และลดความจำเป็นในการใช้ optical modules 800G จำนวนมหาศาล
นี่คือภาพชัดของ AI infrastructure ปี 2026: การแข่งขันไม่ได้อยู่แค่ที่ชิปตัวเดียว แต่อยู่ที่วิธีประกอบชิปจำนวนมากให้กลายเป็นระบบเดียวที่คุ้มไฟ เสถียร และขยายได้
จาก GPU/NPU race สู่ system architecture race
ช่วงสองปีที่ผ่านมา ข่าว AI hardware มักวนอยู่กับจำนวน accelerator, memory bandwidth และกำลังผลิตของ semiconductor supply chain แต่เมื่อโมเดลใหญ่ขึ้นเรื่อย ๆ bottleneck เริ่มย้ายจากตัวชิปไปอยู่ที่การเชื่อมต่อระหว่างชิป
สำหรับ cluster ขนาดใหญ่ ปัญหาหลักคือข้อมูลต้องเดินทางเร็วพอระหว่าง compute node หลายพันตัว ถ้า network ช้า หรือ fault บ่อย สมรรถนะจริงจะต่ำกว่าตัวเลข peak มาก
Huawei จึงวางเรื่อง UnifiedBus, peer-to-peer interconnect, memory addressing แบบรวม และ optical interconnect เป็นแกนของประกาศนี้ เพราะ frontier AI ต้องการ infrastructure ที่ทำให้ accelerator จำนวนมากดูเหมือน pool เดียว ไม่ใช่เครื่องจำนวนมากที่ต่อกันแบบหลวม ๆ
NPO และ Hi-ONE คือเดิมพันเรื่องพลังงาน
รายละเอียดที่น่าจับตาคือ Huawei บอกว่า Hi-ONE เป็น optical engine แบบ NPO ที่พร้อม mass production และมี built-in light source โดยมี transmission capacity 7.2 Tbit/s ต่อ engine
ใน Atlas 960E SuperPoD บริษัทระบุว่าการใช้ Hi-ONE 5,500 หน่วยช่วยลดความต้องการ optical modules 800G ที่เดิมอาจต้องใช้ถึง 48,000 ตัว และลดการใช้ไฟลงมากกว่า 550 กิโลวัตต์
ตัวเลขนี้สำคัญมาก เพราะ AI data center ไม่ได้แพ้ชนะกันที่ capex เท่านั้น แต่แพ้ชนะที่ไฟฟ้า ความร้อน ความซับซ้อนของ cabling และ maintenance ด้วย
ถ้า optical fabric ลดพลังงานและจุดเสียหายได้จริง ต้นทุนต่อ token ในระยะยาวอาจเปลี่ยนอย่างมีนัยสำคัญ โดยเฉพาะงาน inference ที่ต้องรันตลอดเวลา
Liquid cooling กลายเป็น feature พื้นฐาน ไม่ใช่ของหรู
Huawei ระบุว่า Atlas 960E SuperPoD ใช้การออกแบบแบบ fully liquid-cooled ซึ่งสะท้อนภาพรวมของตลาด data center ชัดเจน: เมื่อ accelerator density สูงขึ้น air cooling แบบเดิมไม่พอสำหรับระบบระดับ frontier อีกต่อไป
การทำ liquid cooling ไม่ใช่แค่เอาท่อน้ำมาใส่ rack แต่กระทบทั้งอาคาร data center, power distribution, operations, service procedure และ supply chain ของ component รอบระบบ
ในปี 2026 ผู้ให้บริการ cloud และ enterprise ที่อยาก deploy AI cluster ขนาดใหญ่ต้องคิดเรื่องพลังงานกับ cooling ตั้งแต่แรก ไม่ใช่ซื้อ server ก่อนแล้วค่อยหาวิธีจัดการความร้อนภายหลัง
TaiShan 950, OceanStor M900 และ agent workload
ประกาศเดียวกันยังขยาย SuperPoD architecture ไปยัง general-purpose computing ผ่าน TaiShan 950 SuperPoD ที่รองรับสูงสุด 4,096 nodes และมี unified memory pool สูงสุด 256 TB
Huawei เชื่อมเรื่องนี้เข้ากับ workload ของ agent เช่น sandbox density, startup time และ vector search performance พร้อมเปิดตัว OceanStor M900 สำหรับ context memory storage cluster และ KV cache ขนาด petabyte
นี่น่าสนใจเพราะ infrastructure สำหรับ AI agent ไม่ได้ต้องการแค่ accelerator สำหรับ model inference แต่ต้องมีพื้นที่ execution, storage, memory hierarchy และ retrieval path ที่ตอบสนองเร็วพอ
หากองค์กรเริ่มใช้ agent จำนวนมากพร้อมกัน bottleneck อาจไปอยู่ที่ sandbox, context storage หรือ vector retrieval มากพอ ๆ กับ model serving
SuperCluster และคำถามเรื่อง scale
Huawei ระบุว่า SuperPoD หลายชุดสามารถเชื่อมเป็น SuperCluster ผ่าน UnifiedBus หรือ RoCE โดย architecture แบบ Clos สองชั้นสี่ plane รองรับการเชื่อมต่อสูงสุด 512,000 NPUs และเมื่อใช้ multi-rail topology อาจรองรับระดับ หนึ่งล้าน NPUs
ตัวเลขนี้ใหญ่จนต้องอ่านในฐานะ roadmap มากกว่าของที่ทุกองค์กรจะใช้ทันที แต่มีนัยเชิงตลาดชัดเจน: vendor รายใหญ่กำลังแข่งกันเสนอ stack ที่ scale จาก cluster ไปถึง national-scale AI infrastructure
การแข่งขันจึงไม่ใช่แค่ใครมี chip เร็วสุด แต่ใครมีระบบครบตั้งแต่ silicon, interconnect, cooling, storage, cluster management, software ecosystem และ partner delivery
ผลต่อผู้ซื้อ infrastructure
สำหรับผู้ซื้อในองค์กรหรือ cloud provider ข่าวนี้ให้บทเรียนสำคัญสามข้อ
ข้อแรกคือ benchmark เดี่ยวของ accelerator ไม่พอ ต้องดู system availability, network topology, memory pooling และ energy efficiency ด้วย
ข้อสองคือ vendor lock-in จะซับซ้อนขึ้น เพราะ hardware fabric, accelerator SDK, storage layer และ orchestration อาจผูกกันแน่นขึ้นใน stack เดียว
ข้อสามคือ AI infrastructure กำลังกลายเป็น strategic procurement ที่เกี่ยวพันทั้งเทคนิค การเงิน พลังงาน และภูมิรัฐศาสตร์ ผู้ซื้อจึงต้องประเมิน risk รอบด้านมากกว่าการเปรียบเทียบสเปกบนกระดาษ
สรุป
การเปิดตัว Huawei Atlas 960E SuperPoD เป็นข่าว Hardware / Infrastructure ที่สะท้อนทิศทางชัดเจนว่า AI cluster ปี 2026 แข่งกันที่ architecture ทั้งระบบ
NPO, optical fabric, unified memory, liquid cooling และ context storage กำลังกลายเป็นคำสำคัญพอ ๆ กับจำนวน accelerator เพราะโมเดลระดับ 10 ล้านล้านพารามิเตอร์ต้องการ infrastructure ที่สื่อสารเร็ว ใช้ไฟคุ้ม และทำงานเสถียรใน scale ใหญ่
สิ่งที่ต้องจับตาหลังงาน HUAWEI CONNECT 2026 คือ ecosystem ซอฟต์แวร์และลูกค้าระดับ production จะตามสมรรถนะบนกระดาษได้เร็วแค่ไหน เพราะ hardware ที่ scale ได้จริงต้องพิสูจน์ทั้งใน lab และใน data center ที่ต้องเปิด 24 ชั่วโมงทุกวัน
ภาพประกอบบทความนี้ดาวน์โหลดจากภาพข่าวทางการของ Huawei ขนาด 1600x1000 พิกเซล ผ่านข้อกำหนด cover image ของ repo
แหล่งอ้างอิง
About the Author
บทความที่เกี่ยวข้อง (Related Posts)
Vertiv ส่งมอบ liquid cooling 30 MW ในอินเดีย: AI data center เริ่มวัดความพร้อมที่ชิป ไม่ใช่แค่ที่แร็ก
สรุปข่าว Hardware / Infrastructure วันที่ 20 ตุลาคม 2026 เมื่อ Vertiv ส่งมอบ direct-to-chip liquid cooling ที่ CLDC Mumbai 01 เพื่อรองรับ AI workload 30 MW
NetApp จับมือ Supermicro: AI factory รุ่นถัดไปแข่งกันที่ข้อมูล ไม่ใช่ GPU อย่างเดียว
สรุปข่าว Hardware / Infrastructure วันที่ 30 กันยายน 2026 เรื่อง NetApp และ Supermicro เปิดความร่วมมือ validated AI infrastructure สำหรับ AI factories
NVIDIA DSX Ready เปิดศึก power และ cooling: AI factory ต้องผ่านการรับรองตั้งแต่ไฟถึงระบบระบายความร้อน
สรุปข่าว Hardware / Infrastructure วันที่ 25 กันยายน 2026 เรื่อง NVIDIA เปิดโปรแกรม DSX Ready เพื่อ qualify ระบบ power และ cooling สำหรับ AI factories
NVIDIA Mission Control 2.5 ขยายระบบกู้คืนงาน AI อัตโนมัติมาสู่ Kubernetes
NVIDIA เปิดรายละเอียด Mission Control 2.5 เมื่อ 26 ตุลาคม 2026 รองรับการกู้คืนงาน Kubernetes ผ่าน Run:ai พร้อมเงื่อนไขที่ต้องอ่านก่อนใช้กับ Vera Rubin NVL72