

ครม. รับทราบ Big Data Strategic Plan: ไทยวาง data layer สำหรับ AI และ digital government
สารบัญบทความ (Table of Contents)
ข่าว Thailand / SEA Ecosystem สำหรับรอบวันที่ 28 กรกฎาคม 2026 คือการที่คณะรัฐมนตรีไทยรับทราบ แผนยุทธศาสตร์การขับเคลื่อนการใช้ประโยชน์จาก Big Data พ.ศ. 2568-2570 ในการประชุมวันที่ 27 กรกฎาคม 2026
สำนักข่าวกรมประชาสัมพันธ์รายงานว่าแผนนี้เสนอโดยกระทรวงดิจิทัลเพื่อเศรษฐกิจและสังคม และจัดทำโดย สถาบันข้อมูลขนาดใหญ่ (องค์การมหาชน) หรือ Big Data Institute เพื่อวางฐานให้เศรษฐกิจและสังคมไทยใช้ข้อมูลเป็นตัวขับเคลื่อนมากขึ้น พร้อมยกระดับการใช้ AI และบริการภาครัฐดิจิทัล
นี่เป็นข่าว ecosystem ที่สำคัญ เพราะ AI ของประเทศไม่ได้เริ่มจากโมเดลอย่างเดียว แต่มาจาก data layer, governance, interoperability, cybersecurity, privacy และบุคลากรที่ใช้ข้อมูลได้จริง
แผนนี้พยายามแก้ปัญหา data fragmentation
ใจกลางของข่าวคือรัฐบาลยอมรับว่าปัญหา data ของไทยไม่ใช่แค่ไม่มีข้อมูล แต่ข้อมูลกระจัดกระจายอยู่หลายหน่วยงาน เชื่อมกันไม่ครบ บุคลากรด้าน data และ AI ยังขาด และกติกาเรื่อง cybersecurity, PDPA, กฎหมาย และ infrastructure ยังเป็นข้อจำกัด
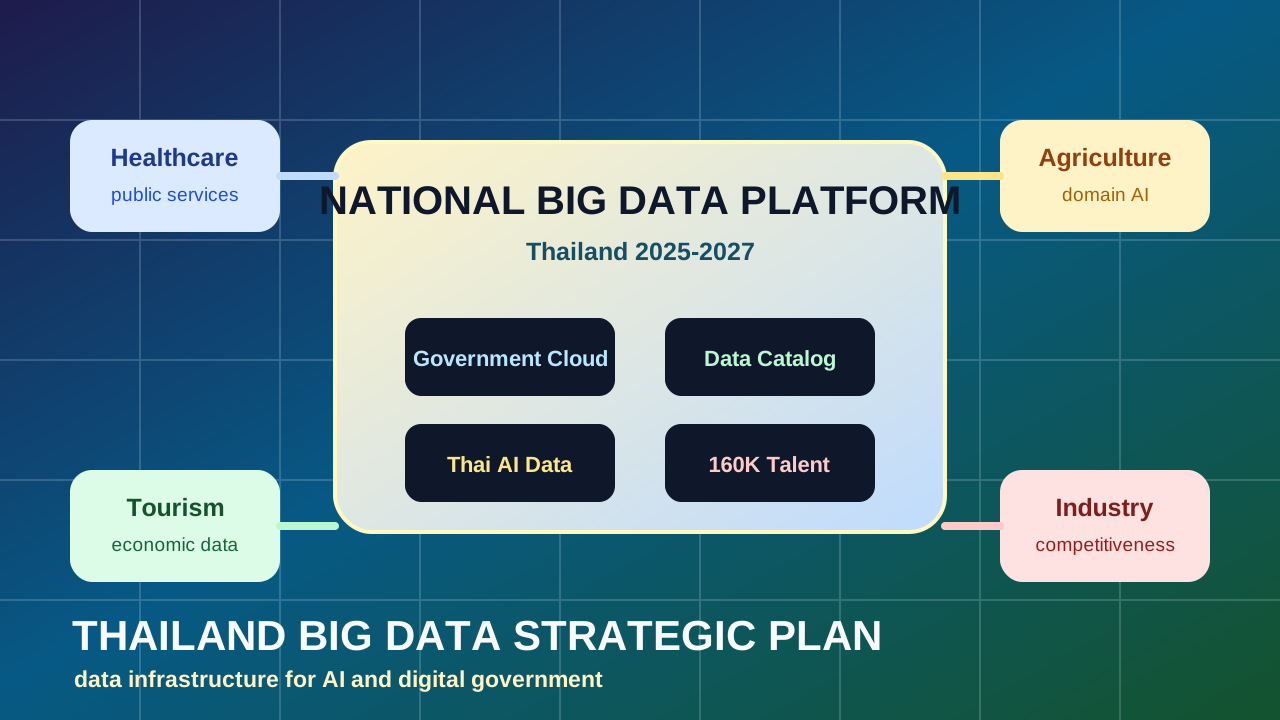
แผน Big Data จึงไม่ได้พูดแค่เรื่อง dashboard หรือ data lake แต่กำหนดให้มี national data infrastructure เช่น:
- Government Cloud
- Government Data Catalog
- National Big Data Platform
- การใช้ข้อมูลใน healthcare, tourism, environment, agriculture, trade และ economic development
- การพัฒนา AI สำหรับบริการรัฐ ธุรกิจ และอุตสาหกรรม
- Thai-language AI models และ datasets
- การยกระดับทักษะ Big Data และ AI ให้บุคลากรอย่างน้อย 160,000 คนภายในปี 2027
เป้าหมายเชิงผลลัพธ์ที่รัฐบาลระบุคือให้ Big Data ช่วยขับเคลื่อน economic growth อย่างน้อย 35% ภายในปี 2027 และให้ไทยติด Top 25 ของโลก ด้าน digital competitiveness ในการใช้ Big Data
ทำไมเรื่องนี้สำคัญต่อ SEA ecosystem
หลายประเทศใน SEA กำลังเร่งสร้าง AI ecosystem แต่แต่ละประเทศติดปัญหาไม่เหมือนกัน
สิงคโปร์มีจุดแข็งด้าน governance, enterprise adoption และทุนข้ามชาติ เวียดนามมีฐานวิศวกรรมและ manufacturing มาเลเซียเริ่มเด่นด้าน data center และ semiconductor ส่วนไทยมีจุดแข็งด้าน public service, tourism, healthcare, agriculture และฐาน SME จำนวนมาก
ถ้าไทยอยากทำ AI ให้เกิด value จริง จุดชี้ขาดไม่ใช่แค่ซื้อโมเดลหรือจัด event แต่คือการทำให้ข้อมูลภาครัฐและภาคธุรกิจเชื่อมกันได้อย่างปลอดภัยและมีมาตรฐาน
ดังนั้น Big Data Strategic Plan จึงควรถูกมองเป็น infrastructure ชั้นล่างของ AI ecosystem ไทย
Thai-language AI เป็นโจทย์ที่ต้องใช้ data policy
ประโยคที่ควรจับตาคือการระบุเรื่อง Thai-language AI models and datasets
ที่ผ่านมา AI adoption ในไทยมักติดอยู่กับคุณภาพภาษาไทย บริบทกฎหมายไทย เอกสารราชการ ภาษาในธุรกิจท้องถิ่น และข้อมูลที่ไม่ได้อยู่ในรูปแบบพร้อมใช้
ถ้ารัฐทำ data catalog, dataset governance และ platform กลางได้ดี จะช่วยให้โมเดลภาษาไทยและ application เฉพาะ domain เช่น healthcare, tourism, agriculture หรือบริการประชาชนมีฐานข้อมูลที่ดีกว่าการ scrape หรือแปลงเอกสารแบบ ad hoc
แต่ความท้าทายคือ data governance ต้องชัดมาก เพราะข้อมูลภาครัฐจำนวนมากเกี่ยวข้องกับประชาชนโดยตรง การผลักดัน AI โดยไม่มี privacy, access control และ audit trail ที่เชื่อถือได้จะทำให้ adoption สะดุดเร็ว
เป้าหมาย 160,000 คนสำคัญกว่าที่ดู
ในข่าว startup เรามักสนใจ funding แต่สำหรับ public-sector AI ตัวคอขวดคือคนที่สามารถแปลงข้อมูลเป็นบริการจริง
เป้าหมายพัฒนาทักษะ Big Data และ AI อย่างน้อย 160,000 คนภายในปี 2027 จึงเป็นตัวเลขที่ควรติดตาม เพราะถ้าฝึกได้แต่ระดับ awareness แผนจะไม่เปลี่ยน workflow จริง แต่ถ้าฝึกให้หน่วยงานทำ data stewardship, analytics, procurement, privacy review และ AI evaluation ได้ นี่จะเป็นฐานที่ช่วยลด dependency ต่อ vendor ภายนอก
สำหรับเอกชน โดยเฉพาะ SME และ startup ไทย นี่อาจเปิดโอกาสให้เกิด service layer ใหม่รอบ data quality, AI governance, Thai dataset tooling, domain-specific assistant และ integration กับระบบราชการ
มุมมองของผม
ผมมองว่าข่าววันที่ 27 กรกฎาคม 2026 นี้เป็นหนึ่งในสัญญาณสำคัญของ Thailand / SEA Ecosystem เพราะมันพูดถึง infrastructure ที่มักไม่หวือหวา แต่จำเป็นมาก
AI policy ที่ดีต้องมีสามชั้นพร้อมกัน: data foundation, talent foundation และ governance foundation แผน Big Data รอบนี้แตะทั้งสามชั้น แต่ความสำเร็จจะวัดจาก execution ไม่ใช่เอกสาร
สิ่งที่ควรจับตาต่อคือ Government Data Catalog และ National Big Data Platform จะเปิดให้หน่วยงานใช้จริงได้แค่ไหน มีมาตรฐาน metadata และ access control ชัดหรือไม่ และ Thai-language AI dataset จะถูกสร้างแบบเปิด ตรวจสอบได้ และใช้ต่อยอดโดย ecosystem ภายนอกได้มากเพียงใด
สรุปสั้น ๆ: วันที่ 27 กรกฎาคม 2026 ครม. รับทราบแผน Big Data 2025-2027 ตั้งเป้า data infrastructure, Thai-language AI และบุคลากร 160,000 คน ข่าวนี้ชี้ว่า AI ecosystem ไทยกำลังวางรากฐานจากข้อมูลก่อนโมเดล
หมายเหตุเรื่องภาพประกอบ
ภาพประกอบบทความนี้เป็น generated local SVG fallback ขนาด 1280x720 พิกเซล เพราะ local shell ของ automation ไม่สามารถ resolve DNS เพื่อดาวน์โหลดภาพจากเว็บได้ในรอบนี้ จึงไม่สามารถบันทึกภาพจากหน้า PRD ลง repo ได้โดยตรง
แหล่งอ้างอิง
About the Author
บทความที่เกี่ยวข้อง (Related Posts)
TH-AI Passport ทะลุ 1.13 ล้านลงทะเบียน: ประเทศไทยกำลังทดสอบ AI access แบบรัฐจ่ายตามผู้ใช้จริง
สรุปข่าว Thailand / SEA Ecosystem วันที่ 23 สิงหาคม 2026 เรื่อง TH-AI Passport มีผู้ลงทะเบียนกว่า 1.13 ล้านคนก่อนเปิดใช้งานเต็มรูปแบบ และโมเดลรัฐจ่ายตาม active user
Webull ถือหุ้น Pi Securities 99.36%: fintech ไทยเข้าสู่เฟสที่แข่งกันด้วย research, AI และ wealth ecosystem
สรุปข่าว Thailand / SEA Ecosystem วันที่ 10 กันยายน 2026 เรื่อง Webull Thailand ปิดดีลซื้อหุ้น Pi Securities 99.36% หลัง SEC อนุมัติ ตั้งเป้า AUM รวม 2 แสนล้านบาท
Thailand-Singapore Forward-Looking Strategic Partnership: AI, digital economy และ payments กลายเป็น agenda ระดับ ASEAN
สรุปข่าว Thailand / SEA Ecosystem วันที่ 8 กันยายน 2026 เรื่องไทยและสิงคโปร์ยกระดับความร่วมมือด้าน AI, digital economy, DEPA, DEFA และ PromptPay-PayNow
Global Startup Hub Demo Day: NIA ใช้ 30 สตาร์ตอัปเป็นสะพาน Thailand Gateway to ASEAN
สรุปข่าว Thailand / SEA Ecosystem วันที่ 22 สิงหาคม 2026 เรื่อง NIA Global Startup Hub 2026 จัด Demo Day วันที่ 21 สิงหาคม เพื่อพาสตาร์ตอัปไทยและต่างชาติสู่ตลาดอาเซียน